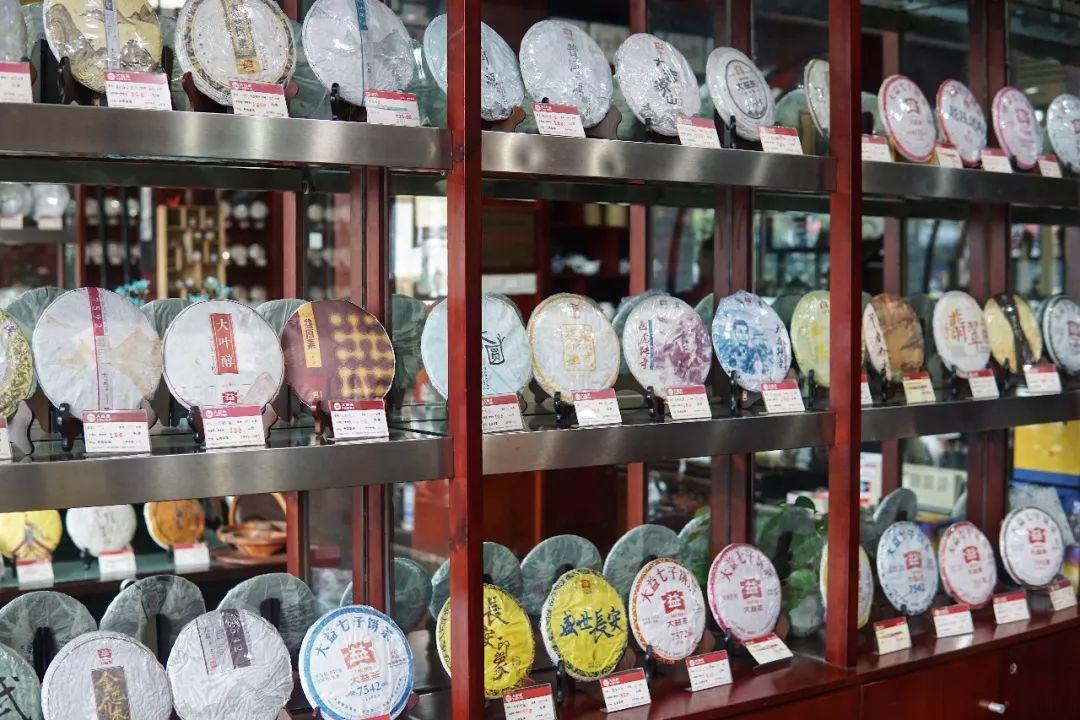
在信息传输、软件和信息技术服务业高速迭代的背景下,茶文化领域的数字化转型正悄然改变着传统品茶资源的获取与流通方式。据中国茶叶流通协会2023年数据显示,全国茶叶年产量达333万吨,涉茶人口超8000万,而其中通过线上渠道获取品茶信息、对接茶叶资源的用户比例首次突破62%。这一数据背后,折射出一个亟待解决的结构性矛盾:海量分散的品茶信息资源与用户精准获取需求之间的鸿沟。
一、品茶信息资源的现状:数据孤岛与信任成本
当前品茶信息资源的分布呈现出典型的“碎片化”特征。产茶区茶农、茶企、茶文化研究者、品鉴爱好者各自掌握着不同维度的信息——从茶园海拔、采摘时节、制作工艺到冲泡参数、口感描述、市场行情。这些信息分散在微信群、短视频平台、垂直论坛及线下茶会中,缺乏统一的元数据标准和结构化整理。
以品茶微信生态为例,据艾瑞咨询《2024年中国垂直社群生态报告》估算,活跃的茶友微信群超过15万个,但其中具备持续内容产出与信息校验能力的不足8%。大量群组沦为广告分发渠道,用户获取有效品茶信息的信任成本与时间成本居高不下。这正是喝茶资源网(jiebiyongshi.com)等平台试图破局的切入点——通过系统化的喝茶信息整理与品茶资源汇总,降低信息熵值。
二、技术赋能:从信息聚合到知识图谱
信息传输与软件技术为品茶信息资源的重构提供了底层支撑。具体而言,三个技术层级正在发挥作用:
- 数据采集与清洗层:利用分布式爬虫与API接口对接,从公开渠道采集茶叶产地信息、品鉴笔记、价格指数等非结构化数据,通过NLP实体识别提取“茶种—产地—工艺—风味”关键字段。
- 结构化存储与检索层:基于Elasticsearch构建全文检索与多维筛选能力,用户可按香型、火功、树龄、海拔等20余个维度精准定位品茶信息资源。
- 知识图谱与推荐层:将茶友交流平台中的UGC内容与专家审评数据关联,形成动态更新的茶文化信息网。例如,当用户查询“武夷岩茶肉桂”时,系统可同步呈现产地气候数据、传统焙火工艺参数、历年斗茶赛获奖记录及全国茶友圈的真实品鉴反馈。
这一技术路径并非空中楼阁。2023年,某省级茶叶研究所与信息技术企业合作,在武夷山试点部署了茶园物联网监测与品鉴信息协同平台,实现从“茶树生长”到“茶杯风味”的全链路数据贯通。试点区域内,茶叶资源对接效率提升约40%,品茶信息资源的采信度显著提高。
三、全国茶友圈的信息闭环:案例与启示
品茶信息资源的终极价值在于流动与匹配。以“全国喝茶资源”整合为例,一个典型的成功闭环包含三个环节:
信息生产端:茶农上传采摘批次、天气记录、初制参数;茶企录入精制工艺与质检报告;资深茶友贡献品鉴笔记与冲泡建议。
信息加工端:平台通过算法去重、交叉验证与权重排序,剔除商业软文与虚假宣传,形成可信度分级。例如,同一款茶若有多位认证茶友的品鉴记录与质检数据吻合,则信息优先级自动提升。
信息消费端:普通用户通过品茶微信社群、小程序或Web端,获取个性化推荐。当用户表达“寻找适合冬季饮用的老白茶”需求时,系统可基于年份、产地、仓储条件及茶友口碑,精准推送3-5款高匹配度选项,并附上真实交易渠道与品鉴报告。
据喝茶资源网后台统计,采用结构化品茶信息资源推荐后,用户从“信息浏览”到“资源对接”的转化率较传统论坛模式提升2.3倍,无效咨询量下降57%。这印证了一个基本判断:在信息传输服务业中,垂直领域的价值不在于信息堆砌,而在于精准降噪与可信连接。
四、未来展望:标准化与智能化并进
品茶信息资源的深度整合,仍需跨越两道门槛。其一是标准化——建立涵盖茶种分类、风味轮术语、产地编码的行业元数据规范,使不同来源的数据可互通、可比较。其二是智能化——引入大语言模型与知识推理技术,实现从“用户问、系统答”到“系统主动识别需求、预判偏好”的跃迁。
可以预见,随着信息传输技术的持续演进与茶文化数字基建的完善,全国喝茶资源将不再是一张模糊的网,而是一幅高精度、可交互、自更新的知识图谱。届时,每一位茶友都能在可信的品茶信息资源中,找到属于自己的那杯茶。